O Desafio da Sobrecarga de Contexto
À medida que os Grandes Modelos de Linguagem (LLMs) se tornam a espinha dorsal da computação moderna, um gargalo persistente tem desafiado pesquisadores e engenheiros: a janela de contexto. Embora modelos recentes tenham expandido sua capacidade de processar milhares de palavras simultaneamente, o custo computacional e a latência crescem de forma quadrática ou linear pesada, tornando o processamento de vastas bibliotecas de documentos proibitivamente caro. É neste cenário que pesquisadores da Universidade de Stanford introduziram o Memorilla, um módulo de memória latente de código aberto projetado para transformar a forma como os LLMs interagem com informações externas.
O Memorilla surge como uma resposta à ineficiência dos métodos tradicionais de Geração Aumentada por Recuperação (RAG) e das janelas de contexto ultra-longas. Enquanto o RAG depende da recuperação de fragmentos de texto bruto que ocupam espaço precioso na memória de trabalho do modelo, o Memorilla propõe uma abordagem radicalmente diferente: a compressão de coleções inteiras de documentos em um conjunto minimalista de “tokens de memória” que residem no espaço latente da rede neural.
A Arquitetura do Memorilla: Compressão em Espaço Latente
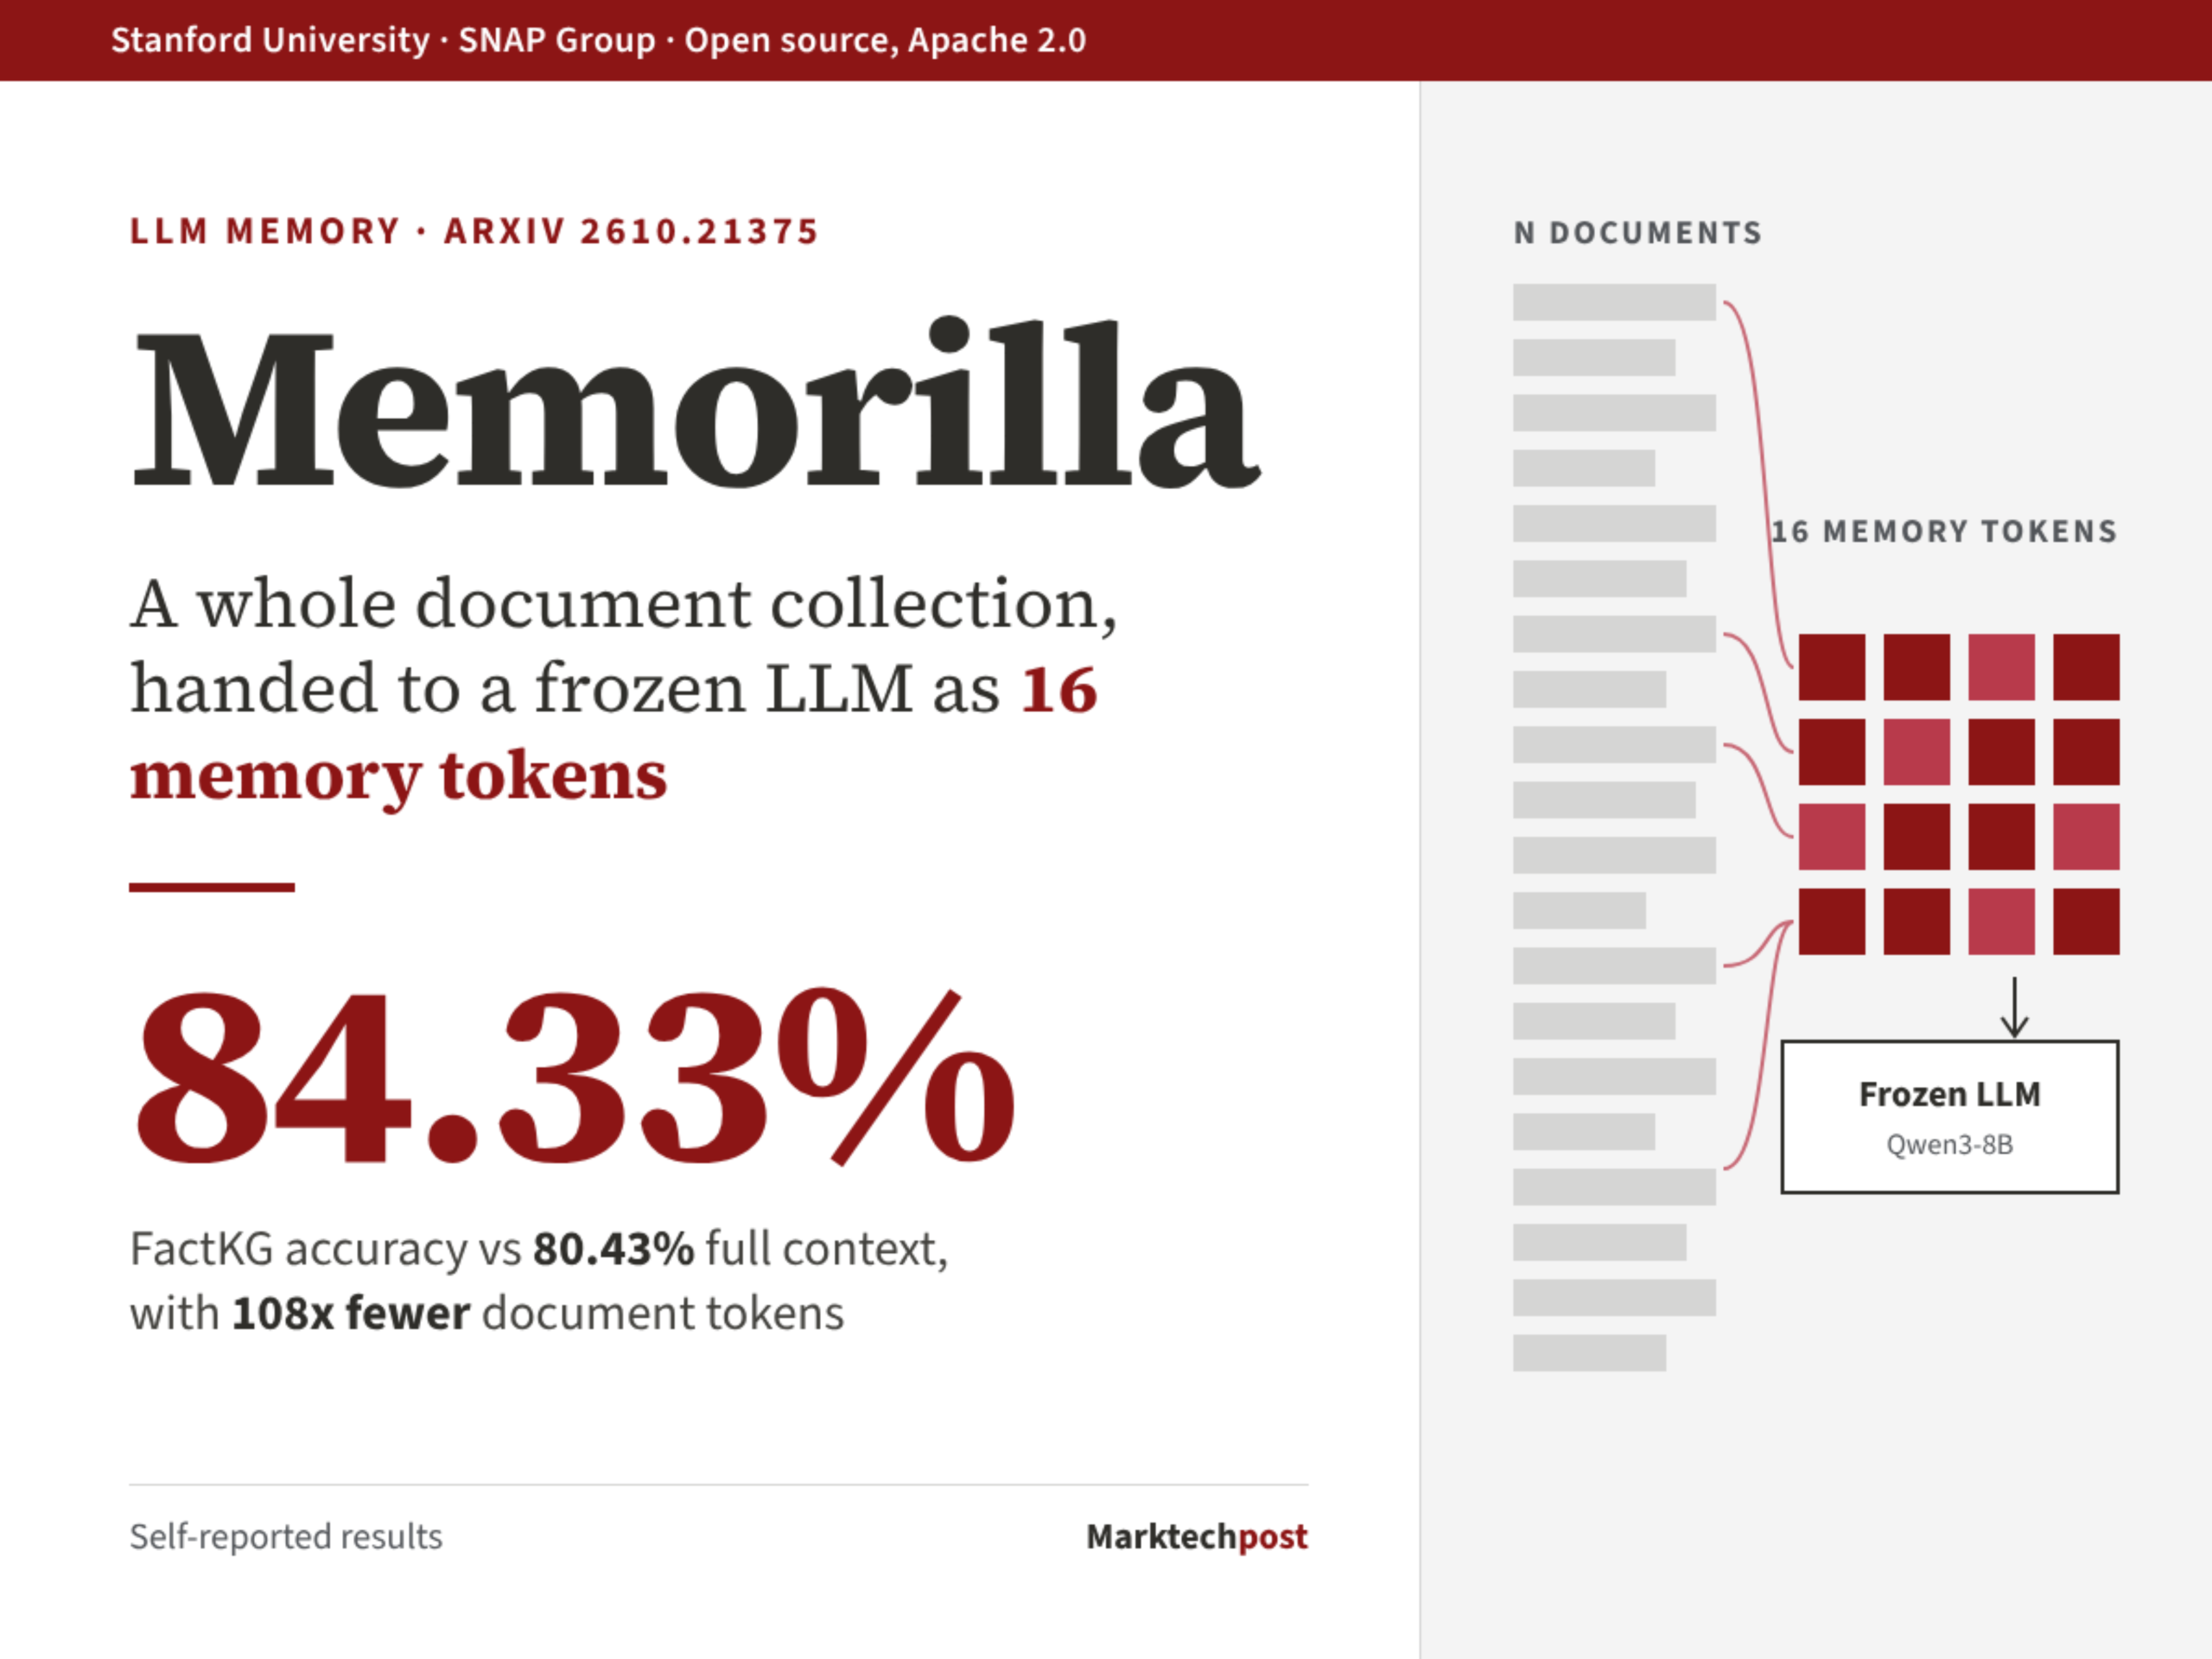
A grande inovação técnica do Memorilla reside na sua capacidade de atuar sobre modelos “congelados” (frozen). No estudo publicado, os pesquisadores utilizaram o Qwen3-8B, mantendo seus pesos originais intactos. O módulo Memorilla funciona como uma camada intermediária que processa coleções de documentos e as destila em apenas 16 tokens de memória. Para contextualizar, em uma abordagem padrão, esses mesmos documentos poderiam ocupar milhares de tokens, consumindo quase toda a capacidade de processamento do modelo.
Essa arquitetura utiliza uma técnica de mapeamento para o espaço latente, onde a informação semântica é preservada de forma densa. Ao contrário de um resumo textual, que pode perder nuances técnicas, os tokens de memória do Memorilla são vetores matemáticos otimizados para serem interpretados pelas camadas de atenção do LLM. O diferencial em relação a tecnologias anteriores, como o RAG convencional, é que o Memorilla elimina a necessidade de reinserir o texto recuperado no prompt a cada consulta. Uma vez que a memória é gerada, ela serve como um “prefixo” altamente informativo que orienta a geração do modelo com uma fração do custo original.
Performance e Eficiência: O Fim do Dilema do Contexto Longo?
Os resultados empíricos apresentados pela equipe de Stanford são notáveis. No benchmark FactKG, uma métrica rigorosa para verificação de fatos e integridade de conhecimento, o Memorilla alcançou uma precisão de 84,33%. O dado mais impressionante, entretanto, é a eficiência: o sistema utilizou 108 vezes menos tokens de documento do que seria necessário em uma configuração de contexto total para atingir resultados semelhantes.
Essa redução drástica no uso de tokens não é apenas uma vitória acadêmica; ela resolve o problema da latência de inferência (Time To First Token - TTFT). Em sistemas de produção, onde cada milissegundo conta, a capacidade de fornecer ao modelo o contexto de uma enciclopédia técnica usando apenas 16 tokens permite que a IA responda quase instantaneamente, sem o atraso típico de modelos que precisam “ler” centenas de páginas antes de formular uma resposta.
Impacto Prático para Indústrias e Desenvolvedores
O impacto do Memorilla para a indústria de software e para a sociedade é profundo. Para desenvolvedores, a natureza de código aberto do projeto permite a implementação de sistemas de IA mais leves e rápidos, que podem rodar em hardware menos potente ou reduzir drasticamente as faturas de APIs de nuvem. Empresas que lidam com grandes volumes de dados proprietários — como escritórios de advocacia, instituições financeiras e centros de pesquisa médica — podem agora utilizar o Memorilla para criar índices de memória latente que protegem a privacidade e aumentam a precisão factual sem a necessidade de re-treinar modelos massivos.
Além disso, a tecnologia sinaliza uma mudança de paradigma na arquitetura de sistemas neurais. Estamos nos movendo de modelos que tentam “lembrar de tudo” em sua memória de curto prazo para sistemas modulares onde a memória é um componente externo, plugável e altamente comprimido. O Memorilla não apenas estende a utilidade de modelos menores, como o Qwen3-8B, mas também democratiza o acesso a capacidades de IA de alto nível, permitindo que o conhecimento global seja processado com uma eficiência energética e computacional sem precedentes.
- Via: Stanford Research Open-Sources Memorilla, a Latent Memory Module for Frozen LLMs – MarkTechPost.
Sobre a Redação
A Redação QOrigin é o núcleo de jornalismo científico do QOrigin News, dedicado a transformar pesquisas acadêmicas de fronteira em análises aprofundadas sobre computação quântica, física, exploração espacial e arquitetura de sistemas avançados.